MySQL基础
SQL
DQL-查询
DQL-编写顺序
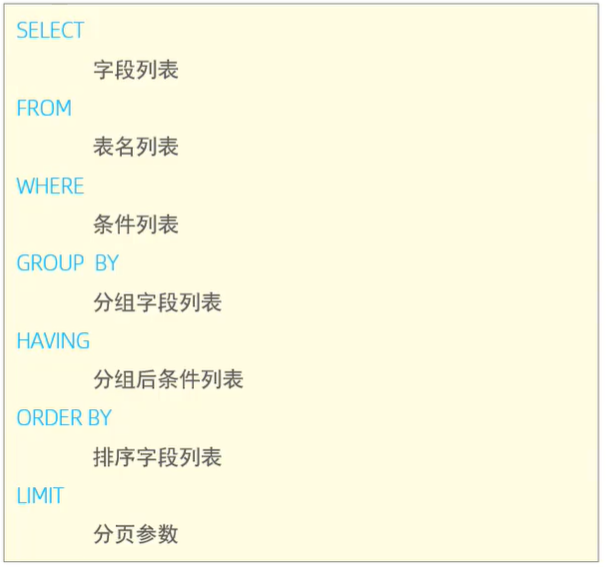
DQL-执行顺序
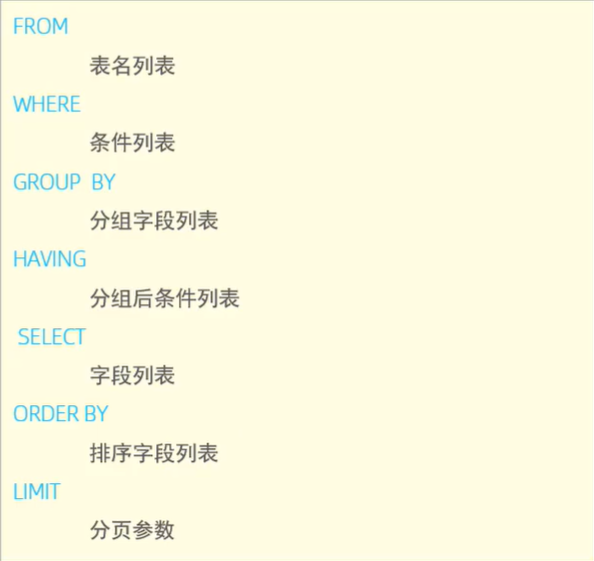
DCL - 权限控制
1. 用户管理
创建用户
1
CREATE USER 'user'@'主机名' IDENTIFIED BY 'password';
修改用户
1
ALTER USER 'user'@'主机名' IDENTIFIED WITH MYSQL_NATIVE_PASSWORD BY 'password';
删除用户
1
DROP USER 'user'@'主机名';
2. 权限控制
查询权限
1
SHOW GRANTS FOR '用户名'@'主机名';
授予权限
1
GRANT 权限列表 ON 数据库名.表名 TO '用户名'@'主机名';
撤销权限
1
REVOKE 权限列表 ON 数据库名.表名 TO '用户名'@'主机名';
函数
1. 字符串函数
- CONCAT(S1,S2,…Sn) 字符串拼接,将S1,S2,…Sn拼接成一个字符串
- LOWER(str) 将字符串str全部转为小写
- UPPER(str) 将字符串str全部转为大写
- LPAD(str,n,pad) 左填充,用字符串pad对str的左边进行填充,达到n个字符串长度
- RPAD(str,n,pad) 右填充,用字符串pad对str的右边进行填充,达到n个字符串长度
- TRIM(str) 去掉字符串头部和尾部的空格
- SUBSTRING(str,start,len) 返回从字符串str从start位置起的len个长度的字符串
2. 数值函数
- CEIL(x) 向上取整
- FLOOR(x) 向下取整
- MOD(xy) 返回x/y的模
- RAND() 返回0~1内的随机数
- ROUND(x,y) 求参数x的四舍五入的值,保留y位小数
3. 日期函数
- CURDATE() 返回当前日期
- CURTIME() 返回当前时间
- NOW() 返回当前日期和时间
- YEAR(date) 获取指定date的年份
- MONTH(date) 获取指定date的月份
- DAY(date) 获取指定date的日期
- DATE_ADD(date, INTERVAL expr type) 返回一个日期/时间值加上一个时间间隔expr后的时间值
- DATEDIFF(date1 ,date2) 返回起始时间date1和结束时间date2之间的天数
4. 流程函数
- lF(value , t , f) 如果value为true,则返回t,否则返回f
- IFNULL(value1 , value2) 如果value1不为空,返回value,否则返回value2
- CASE WHEN [ val1 ] THEN [res1] …ELSE [ default ] END 如果val1为true,返回res1,…否则返回default默认值
- CASE [ expr ] WHEN [ val1 ] THEN [res1] …ELSE [ default ] END 如果expr的值等于val7,返回res1,..否则返回default默认值
约束
类型
| 约束 | 描述 | 关键字 |
|---|---|---|
| 非空约束 | 限制该字段的数据不能为null | NOT NULL |
| 唯一约束 | 保证该字段的所有数据都是唯一、不重复的 | UNIQUE |
| 主键约束 | 主键是一行数据的唯一标识,要求非空且唯一 | PRIMARY KEY |
| 默认约束 | 保存数据时,如果未指定该字段的值,则采用默认值 | DEFAULT |
| 检查约束(8.0.16版本之后) | 保证字段值满足某一个条件 | CHECK |
| 外键约束 | 用来让两张表的数据之间建立连接,保证数据的一致性和完整性 | FOREIGN KEY |
添加外键
1
ALTERE TABLE 子表名 ADD CONSTRAINT 键名 FOREIGN KEY (关联字段) REFERENCES 父表(目标字段);
删除外键
1
ALTERE TABLE 子表名 drop FOREIGN KEY 键名;
删除/更新行为
NO ACTION 当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有则不允许删除/更新。(与RESTRICT一致)
RESTRICT 当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有则不允许删除/更薪。(与NO ACTION一致)
CASCADE 当在父表中删除/更新对应记录时,首先检查该记录是否有对应外键,如果有,则也删除/更新外键在子表中的记录。
SET NULL 当在父表中删除对应记录时,首先检查该记录是否有对应外键,如果有则设置子表中该外键值为null(这就要求该外键允许取null)。
SET DEFAULT 父表有变更时,子表将外键列设置成一个默认的值(Innodb不支持)
添加外键约束并添加规则
1
ALTERE TABLE 子表名 ADD CONSTRAINT 键名 FOREIGN KEY (关联字段) REFERENCES 父表(目标字段) ON UPDATE 行为1 ON DELETE 行为2;
多表查询
1. 多表关系
- —对多(多对一) 外键
- 多对多 中间表
- 一对一 外键添加约束(unique)
2. 连接查询
内连接 查询交集部分的数据
隐式内连接
1
SELECT 字段列表 FROM表1,表2 WHERE 条件...;
显式内连接
1
SELECT 字段列表 FROM 表1 [INNER] JOIN 表2 ON 连接条件...;
外连接
左外连接:查询左表所有数据,以及两张表交集部分数据
1
SELECT 字段列表 FROM 表1 LEFT [OUTER] JOIN 表2 ON 条件...;
右外连接:查询右表所有数据,以及两张表交集部分数据
1
2
SELECT 字段列表 FROM 表1 RIGHT [OUTER] JOIN 表2 ON 条件...;
自连接 当前表与自身的连接查询,自连接必须使用表别名
1
SELECT 字段列表 FROM 表A 别名A JOIN 表A 别名 B ON条件...;
3. 联合查询
- UNION ALL 直接将所有结果合并
- UNION 合并结果并去重
- 查询结果列数必须保持一致
4. 子查询
SQL语句中嵌套SELECT语句,称为嵌套查询,又称子查询。
1
SELECT * FROM t1 WHERE column1 = ( SELECT column1 FROM t2);
1. 根据结果
标量子查询(子查询结果为单个值) =、<>、>、>=、<、<=
列子查询(子查询结果为一列) IN、NOT IN 、ANY 、SOME、ALL
操作符 说明 IN 在指定的集合范围之内,多选一 NOT IN 不在指定的集合范围之内 ANY 子查询返回列表中,有任意一个满足即可 SOME 与ANY等同,使用SOME的地方都可以使用ANY ALL 子查询返回列表的所有值都必须满足 行子查询(子查询结果为一行,n列) =、<>、IN、NOT IN
表子查询(子查询结果为多行多列) IN
2. 根据位置
- WHERE之后
- FROM之后
- SELECT之后
事务
事务操作
查看/设置事务提交方式
1
2
SELECT @@autocommit;
SET @@autocommit=0;开启事务
1
START TRANSACTION或 BEGIN;
提交事务
1
COMMIT ;
回滚事务
1
ROLLBACK;
事务四大特性
- 原子性(Atomicity):事务是不可分割的最小操作单元,要么全部成功,要么全部失败。
- 一致性(Consistency)︰事务完成时,必须使所有的数据都保持一致状态。
- 隔离性(lsolation)︰数据库系统提供的隔离机制,保证事务在不受外部并发操作影响的独立环境下运行。
- 持久性(Durability):事务一旦提交或回滚,它对数据库中的数据的改变就是永久的。
并发事务问题
- 脏读 一个事务读到另外一个事务还没有提交的数据。
- 不可重复读 一个事务先后读取同一条记录,但两次读取的数据不同,称之为不可重复读。
- 幻读 一个事务按照条件查询数据时,没有对应的数据行,但是在插入数据时,又发现这行数据已经存在,好像出现了幻影”。
事务隔离级别
| 隔离级别 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|
| Read uncommitted | √ | √ | √ |
| Read committed | × | √ | √ |
| Repeatable Read(默认) | × | × | √ |
| Serializable | × | × | × |
1 | --查看事务隔离级别 |
MySQL进阶
存储引擎
1. MySQL体系结构

- 连接层
最上层是一些客户端和链接服务,主要完成一些类似于连接处理、授权认证、及相关的安全方案。服务器也会为安全接入的每个客户端验证它所具有的操作权限。 - 服务层
第二层架构主要完成大多数的核心服务功能,如SQL接口,并完成缓存的查询,SQL的分析和优化,部分内置函数的执行。所有跨存储引擎的功能也在这一层实现,如过程、函数等。 - 引擎层
存储引擎真正的负责了MySQL中数据的存储和提取,服务器通过API和存储引擎进行通信。不同的存储引擎具有不同的功能,这样我们可以根据自己的需要,来选取合适的存储引擎。 - 存储层
主要是将数据存储在文件系统之上,并完成与存储引擎的交互。
2. 存储引擎简介
存储引擎就是存储数据、建立索引、更新/查询数据等技术的实现方式。存储引擎是基于表的,而不是基于库的,所以存储引擎也可被称为表类型。
在创建表时,指定存储引擎
1
2
3
CREATE TABLE表名(
字段1字段1类型[COMMENT字段1注释],
字段n 字段n类型[COMMENT 字段n注释])ENGINE=INNODB [ COMMENT 表注释];查看当前数据库支持的存储引擎
1
SHOW ENGINES ;
3. 存储引擎特点
1. lnnoDB
介绍
InnoDB是一种兼顾高可靠性和高性能的通用存储引擎,在MySQL5.5之后,InnoDB是默认的MySQL存储引擎。特点
- DML操作遵循ACID模型,支持事务;
- 行级锁,提高并发访问性能;
- 支持外键FOREIGN KEY约束,保证数据的完整性和正确性;
文件
XXX.ibd: xxx代表的是表名,innoDB引擎的每张表都会对应这样一个表空间文件,存储该表的表结构(frm、sdi)、数据和索引。
参数: innodb_file_per_table
查看
.ibd文件命令(打开命令行)1
ibd2sdi 文件名.ibd
逻辑存储结构
- TableSpece:表空间
- Segment:段
- EXtent:区
- Page:页
- Row:行


2. MyISAM
- 介绍
MyISAM是MySQL早期的默认存储引擎。 - 特点
- 不支持事务,不支持外键
- 支持表锁,不支持行锁
- 访问速度快
- 文件
XXX.sdi:存储表结构信息
XXX.MYD:存储数据
XXX.MYI:存储索引
3. Memory
介绍
Memory引擎的表数据时存储在内存中的,由于受到硬件问题、或断电问题的影响,只能将这些表作为临时表或缓存使用。
特点
- 内存存放
- hash索引(默认)
文件
xxx.sdi:存储表结构信息
4.区别
| 特点 | InnoDB | MylSAM | Memory |
|---|---|---|---|
| 存储限制 | 64TB | 有 | 有 |
| 事务安全 | 支持 | - | - |
| 锁机制 | 行锁 | 表锁 | 表锁 |
| B+tree索引 | 支持 | 支持 | 支持 |
| Hash索引 | - | - | 支持 |
| 全文索引 | 支持(5.6版本之后) | 支持 | - |
| 空间使用 | 高 | 低 | N/A |
| 内存使用 | 高 | 低 | 中等 |
| 批量插入速度 | 低 | 高 | 高 |
| 支持外键 | 支持 | - | - |
4.存储引擎选择
在选择存储引擎时,应该根据应用系统的特点选择合适的存储引擎。对于复杂的应用系统,还可以根据实际情况选择多种存储引擎进行组合。
- InnoDB:是Mysql的默认存储引擎,支持事务、外键。如果应用对事务的完整性有比较高的要求,在并发条件下要求数据的一致性,数据操作除了插入和查询之外,还包含很多的更新、删除操作,那么InnoDB存储引擎是比较合适的选择。
- MyISAM:如果应用是以读操作和插入操作为主,只有很少的更新和删除操作,并且对事务的完整性、并发性要求不是很高,那么选择这个存储引擎是非常合适的。
- MEMORY:将所有数据保存在内存中,访问速度快,通常用于临时表及缓存AMEMORY的缺陷就是对表的大小有限制,太大的表无法缓存在内存中,而且无法保障数据的安全性。
索引
索引(index)是帮助MysQL,高效获取数据的数据结构(有序)。在数据之外,数据库系统还维护着满足特定查找算法的数据结构,这些数据结构以某种方式引用(指向)数据,这样就可以在这些数据结构上实现高级查找算法,这种数据结构就是索引。
1. 索引概述
优点
提高数据检索的效率,降低数据库的IO成本
通过索引列对数据进行排序,降低数据排序的成本,降低CPU的消耗。缺点
索引列也是要占用空间的。
索引大大提高了查询效率,同时却也降低更新表的速度,如对表进行INSERT、UPDATE、DELETE时,效率降低。
2. 索引结构
MySQL的索引是在存储引擎层实现的,不同的存储引擎有不同的结构
| 索引结构 | 描述 |
|---|---|
| B+Tree索引 | 最常见的索引类型,大部分引擎都支持B+树索引 |
| Hash索引 | 底层数据结构是用哈希表实现的,只有精确匹配索引列的查询才有效,不支持范围查询 |
| R-tree(空间索引) | 空间索引是MylSAM引擎的一个特殊索引类型,主要用于地理空间数据类型,通常使用较少 |
| Full-text(全文索引) | 是一种通过建立倒排索引,快速匹配文档的方式。类似于Lucene,Solr,ES |
| 索引 | InnoDB | MylSAM | Memory |
|---|---|---|---|
| B+tree索引 | 支持 | 支持 | 支持 |
| Hash索引 | 不支持 | 不支持 | 支持 |
| R-tree索引 | 不支持 | 支持 | 不支持 |
| Full-text | 5.6版本之后支持 | 支持 | 不支持 |
1. 二叉树
- 二叉树缺点:顺序插入时,会形成一个链表,查询性能大大降低。大数据量情况下,层级较深,检索速度慢。
- 红黑树:大数据量情况下,层级较深,检索速度慢。
2. B-Tree (多路平衡查找树)
指针比节点数多一,当插入节点比最大节点多时,中间简节点向上分裂。
3. B+Tree
- 所有的数都出现在叶子结点中,非叶子节点只起到节点的作用
- 所有的叶子结点形成单向列表
- MySQL索引数据结构对经典的B+Tree进行了优化。在原B+Tree的基础上,增加一个指向相邻叶子节点的链表指针,就形成了带有顺序指针的B+Tree,提高区间访问的性能。
4. Hash
哈希索引就是采用一定的hash算法,将键值换算成新的hash值,映射到对应的槽位上,然后存储在hash表中。
3. 索引分类
4. 索引语法
5. SQL性能分析
6. 索引使用
7. 索引设计原则
SQL优化
视图/存储过程/触发器
锁
lnnoDB引擎
MySQL管理