xpath
简介:
XPath 是一门在 XML 文档中查找信息的语言。XPath 可用来在 XML 文档中对元素和属性进行遍历。
1、xpath的结点关系
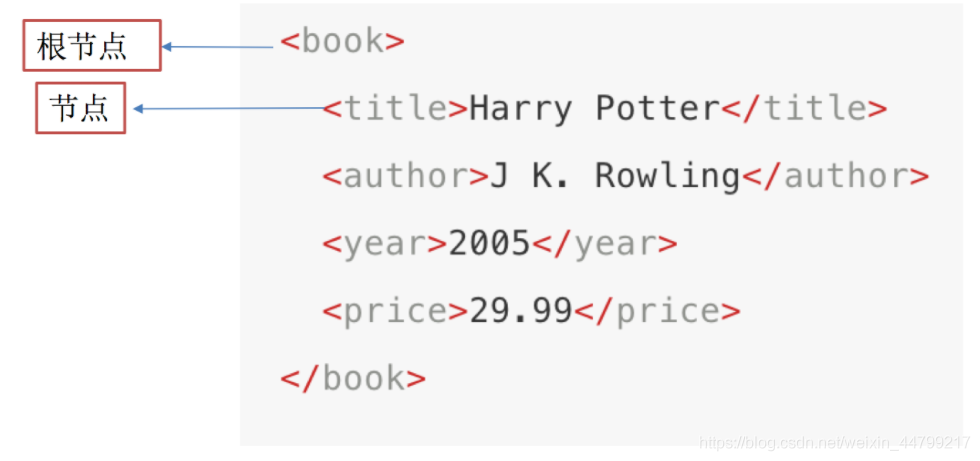
1.xpath中的结点是什么
- 每个`XML`的标签我们都称之为节点,其中最顶层的称之为根节点
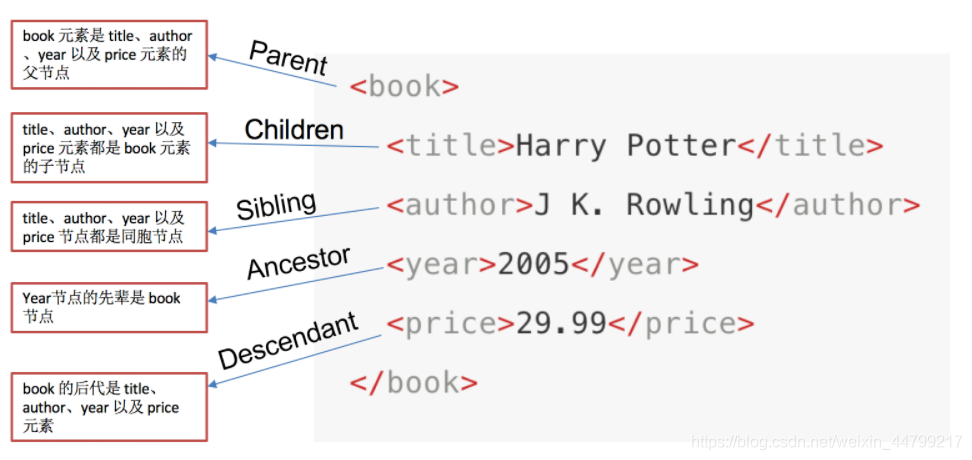
2. xpath节点关系
2、xpath语法
2.1选取节点
XPath使用路径表达式来选取XML文档中的节点或者节点集。这些路径表达式和我们在常规的电脑文件系统中看到的表达式非常相似。使用chrome插件选择标签时候,选中时,选中的标签会添加属性class="xh-highlight"
| 表达式 | 描述 |
|---|---|
| nodename | 选中该元素 |
| / | 从根节点选取、或者是元素和元素间的过度 |
| // | 从匹配选择的当前节点选择文档中的节点,而不考虑它们的位置 |
| . | 选取当前节点 |
| .. | 选取当前节点的父节点 |
| @ | 选择属性 使用:nodename[@属性=’’] |
| text() | 选择文本 |
2.2 查找特定节点

2.3 常用语法
// 的用途
- //a当前html页面上的所有的a

- bookstore//book bookstore下的所有的book元素
@ 的使用
- //a/@href 所有的a的href
- //title[@lang=”eng”]选择lang=eng的title标签
text() 的使用
- //a/text()获取所有的a下的文本
- //a[text()=’下一页’]获取文本为下一页的a标签
- a//text() 获取a下的所有文本
2.4 选取未知节点
- xpath通配符可用来选取未知的XML元素

3、使用lxml
3.1 安装lxml模块
- pip install lxml
3.2 lxml的使用
- 导入
lxml的rtree库 - 利用
etree.HTML,将字符串转化为Element对象,Element对象具有xpath的方法,返回结果的列表,能够接受bytes类型的数据和str类型的数据 - 把转化后的element对象转化为字符串,返回bytes类型结果etree.tostring(element)
1 | from lxml import etree |
3.3 url解码
- 当获取到的连接有很多百分号且数据不清晰是进行url解码
1
2
3
import requests
requests.utils.unquote(url)
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来自 一只小可乐!
相关推荐