JPA
1、JPA概述

1. Jpa是什么?
1)Java Persistence API:用于对象持久化的 API
2)Java EE 5.0 平台标准的 ORM 规范,使得应用程序以统一的方式访问持久层

2、JPA和Hibernate的关系
1)JPA 是 hibernate 的一个抽象(就像JDBC和JDBC驱动的关系):
JPA 是规范:JPA 本质上就是一种 ORM 规范,不是ORM 框架 —— 因为 JPA 并 未提供 ORM 实现,它只是制订了一些规范,提供了一些编程的 API 接口,但 具体实现则由 ORM 厂商提供实现
Hibernate 是实现:Hibernate 除了作为 ORM 框架之外,它也是一种 JPA 实现
2)从功能上来说, JPA是Hibernate功能的一个子集
3、JPA的优势
1)标准化:
提供相同的 API,这保证了基于JPA 开发的企业应用能够经过少量的修改就能够在不同的 JPA 框架下运行。
2)简单易用,集成方便:
JPA 的主要目标之一就是提供更加简单的编程模型,在 JPA 框架下创建实体和创建 Java 类一样简单,只需要使用 javax.persistence.Entity 进行注释;JPA 的框架和接口也都非常简单,
3)可媲美JDBC的查询能力**: **
JPA的查询语言是面向对象的,JPA定义了独特的JPQL,而且能够支持批量更新和修改、JOIN、GROUP BY、HAVING 等通常只有 SQL 才能够提供的高级查询特性,甚至还能够支持子查询。
4)支持面向对象的高级特性:
JPA 中能够支持面向对象的高级特性,如类之间的继承、多态和类之间的复杂关系,最大限度的使用面向对象的模型
4、JPA的技术,包括三方面
1)ORM映射元数据:
JPA 支持 XML 和JDK 5.0 注解两种元数据的形式,元数据描述对象和表之间的映射关系,框架据此将实体对象持久化到数据库表中。
2)JPA的API:
用来操作实体对象,执行CRUD操作,框架在后台完成所有的事情,开发者从繁琐的 JDBC和 SQL代码中解脱出来。
3)查询语言(JPQL):
这是持久化操作中很重要的一个方面,通过面向对象而非面向数据库的查询语言查询数据,避免程序和具体的 SQL 紧密耦合。
5、JPA注解
1. @Entity
@Entity 标注用于实体类声明语句之前,指出该Java类为实体类,将映射到指定的数据库表。如声明一个实体类 Customer,它将映射到数据库中的 customer 表上。
2. @Table
- 当实体类与其映射的数据库表名不同名时**需要使用 **@Table 标注说明,该标注与 @Entity标注并列使用,置于实体类声明语句之前,可写于单独语句行,也可与声明语句同行。
- @Table 标注的常用选项是 name,用于指明数据库的表名
- @Table标注还有一个两个选项 catalog 和 schema 用于设置表所属的数据库目录或模式,通常为数据库名。uniqueConstraints 选项用于设置约束条件,通常不须设置。
1 |
|
3. @Id
@Id 标注用于声明一个实体类的属性映射为数据库的主键列。该属性通常置于属性声明语句之前,可与声明语句同行,也可写在单独行上。
@Id标注也可置于属性的getter方法之前。
4. @GeneratedValue
@GeneratedValue 用于标注主键的生成策略,通过 strategy 属性指定。默认情况下,JPA 自动选择一个最适合底层数据库的主键生成策略:SqlServer 对应 identity,MySQL 对应 auto increment。
在 javax.persistence.GenerationType 中定义了以下几种可供选择的策略:
IDENTITY:采用数据库 ID自增长的方式来自增主键字段,Oracle 不支持这种方式;
AUTO:JPA自动选择合适的策略,是默认选项;
SEQUENCE:通过序列产生主键,通过 @SequenceGenerator 注解指定序列名,MySql 不支持这种方式
TABLE:通过表产生主键,框架借由表模拟序列产生主键,使用该策略可以使应用更易于数据库移植。
5. @Basic
@Basic 表示一个简单的属性到数据库表的字段的映射,对于没有任何标注的 getXxxx() 方法,默认即为@Basic
- fetch: 表示该属性的读取策略,有 EAGER 和 LAZY 两种,分别表示主支抓取和延迟加载,默认为 EAGER.
- optional:表示该属性是否允许为null, 默认为true
6.@Column
当实体的属性与其映射的数据库表的列不同名时需要使用@Column 标注说明,该属性通常置于实体的属性声明语句之前,还可与 @Id 标注一起使用。
- @Column 标注的常用属性是 name,用于设置映射数据库表的列名。此外,该标注还包含其它多个属性,如:unique 、nullable、length 等。
- @Column 标注的 columnDefinition 属性: 表示该字段在数据库中的实际类型.通常 ORM 框架可以根据属性类型自动判断数据库中字段的类型,但是对于Date类型仍无法确定数据库中字段类型究竟是DATE,TIME还是TIMESTAMP 此外,String的默认映射类型为VARCHAR, 如果要将 String 类型映射到特定数据库的 BLOB 或TEXT 字段类型.
- @Column标注也可置于属性的getter方法之前
7. @Transient
- 表示该属性并非一个到数据库表的字段的映射,ORM框架将忽略该属性.
- 如果一个属性并非数据库表的字段映射,就务必将其标示为@Transient,否则,ORM框架默认其注解为@Basic
8. @Temporal
在核心的 Java API 中并没有定义 Date 类型的精度(temporal precision). 而在数据库中,表示 Date 类型的数据有 DATE, TIME, 和 TIMESTAMP 三种精度(即单纯的日期,时间,或者两者 兼备). 在进行属性映射时可使用@Temporal注解来调整精度.
6、JPA常用接口
1、 Repository
概念:·
repositoryjpa的最终的父接口,该接口中定义对数据库操作的一些定义的方法规范和注解
作用:
- 自定义方法规范
- 注解
@Query
自定义方法规范
repostiory中没有定义查询的方法,但是提供一套默认的方法解析规范,我们只需要遵循该规 范的标准并自定义其方法即可被jpa所识别并自动生成其正确的sql来实现真正的动态的查询。
方法名组合:方法前缀 + 实体类属性(查询条件的参数) + 条件关键字
方法前缀:find、findBy、read、readBy、get、getBy
repository支持的注解
repository也支持使用@Query的方法来自定义sql来实现查询的效果;
@Query(value=”语句”,nativeQuery=true)
value:方法数据库的语句
nativeQuery:是否是SQL语句 true:sql语句, false:hql语句
hql:直接从from开始,直接操作的是实体中的属性和实体类名
2、CrudRepository
CrudRepository是repository的子接口,该接口的主要目的就是新增了对数据的增删改查的 功能方法
方法集【在类中使用 Ait+7 调出全部及方法】

3、PagingAndSortingRepository
PagingAndSortingRepository是CrudRepository的子接口,该接口的主要目的是对数据进行分页
方法:
1 | Iterable<T> findAll(Sort var1); |
4、JpaRepository
在开发中常用JPARepository ,是以上接口中最终的子接口
优点:对继承父接口中方法的返回值进行了适配,因为在父类接口中通常都返回迭代器,需要我们自己进行强制 类型转化。而在JpaRepository中,直接返回了List
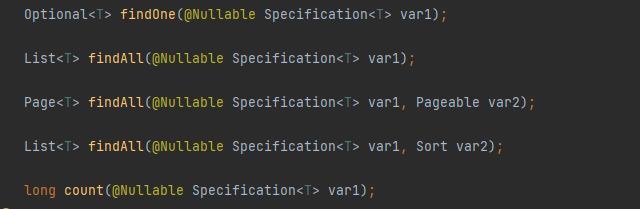
5、JpaSpecificationExecutor